Почему нейросети рисуют шахматную сетку: устройство обучаемого увеличения изображения
Транспонированная свёртка, resize-convolution и перестановка каналов решают одну задачу разными способами. Разбираемся, откуда берутся периодические артефакты и какие операции стоят за восстановлением разрешения.
Откуда берётся необходимость увеличить карту признаков
Свёрточная сеть работает не только с готовыми фотографиями, но и с промежуточными картами признаков. В такой карте каналы описывают разные признаки, а две пространственные оси сохраняют расположение элементов. При обработке изображения разрешение часто уменьшается: это расширяет область исходной сцены, которую охватывает последующий слой, и позволяет выполнять часть вычислений на меньшей сетке. Однако декодеру автокодировщика, генератору изображения или сети сегментации затем требуется снова получить подробный пространственный результат.
В руководстве Vincent Dumoulin и Francesco Visin свёртка представлена как разреженное линейное преобразование. Один и тот же набор весов применяется в разных положениях, причём выходной размер определяется ядром, шагом и заполнением границ. Шаг больше единицы пропускает часть возможных положений окна. Поэтому несколько разных размеров входа могут дать одинаковый размер выхода: операция уже не содержит однозначной информации о первоначальной геометрии.
Обратное направление по размерам не равно восстановлению утраченных данных. Для увеличения карты нужно определить, каким образом её элементы влияют на более плотную сетку. От выбора этой операции зависят не только вычисления, но и характер повторяющихся структур в результате.
Что на самом деле делает ConvTranspose2d
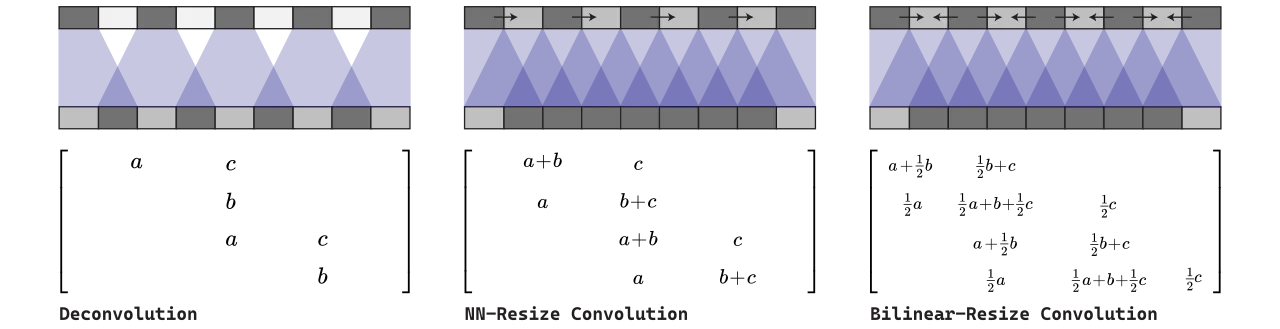
Название «деконволюция» создаёт впечатление математического обращения свёртки. Документация PyTorch прямо уточняет: ConvTranspose2d не вычисляет истинную обратную операцию. Его можно рассматривать как градиент Conv2d по входу. При шаге больше единицы между пространственными элементами вставляются нули, после чего применяется обучаемое ядро. Таким образом получается увеличение разрешения, параметры которого подбираются вместе с остальной сетью.
Выходной размер по каждой оси зависит от входного размера, stride, padding, dilation, kernel_size и output_padding. Последний параметр нужен из-за неоднозначности размеров: он выбирает один из возможных вариантов выходной геометрии, а не дописывает к готовой картинке полосу нулей. Высота и ширина могут настраиваться раздельно, поскольку параметры принимают пары значений.
Канальная структура тоже участвует в операции. При groups=1 каждый входной канал соединяется со всеми выходными. Группы разделяют эти связи на независимые части, а dilation меняет расстояние между элементами ядра. Эти настройки описывают сам вычислительный слой; они ещё ничего не говорят о том, какие текстуры он научится синтезировать после обучения.
Почему перекрытия складываются в шахматный узор
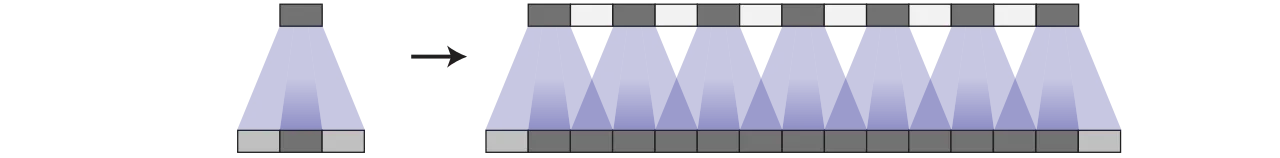
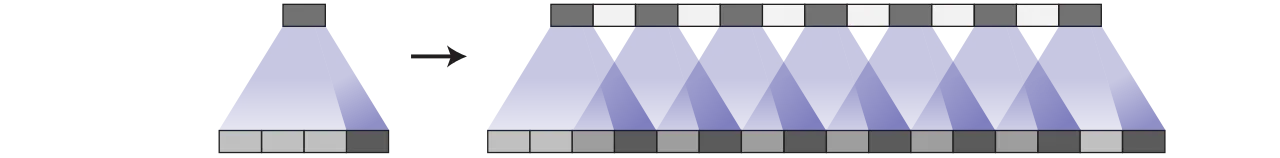
В исследовании Distill 2016 года источник характерной сетки показан на геометрии перекрытий. Каждый элемент небольшой карты словно оставляет отпечаток ядра на большей. Если размер ядра не делится на шаг, одни выходные позиции получают больше вкладов, чем соседние. Для ядра размером три и шага два в одном измерении число вкладов различается вдвое; в двух измерениях эффекты по горизонтали и вертикали перемножаются, и различие достигает четырёх раз.
Несколько увеличивающих слоёв способны накладывать такие структуры на разных масштабах. Обучение теоретически может подобрать компенсирующие веса, но тогда часть свободы фильтров расходуется на устранение артефакта самой архитектуры. Авторы также показали, что даже равномерное геометрическое перекрытие не запрещает сети выучить периодический рисунок.
Вариант resize-convolution разделяет две операции: сначала готовая интерполяция увеличивает пространственную сетку, затем обычная свёртка рассчитывает признаки. В экспериментах авторов интерполяция ближайшего соседа с последующей свёрткой устраняла наблюдаемую сетку. Это результат конкретной работы, а не утверждение, что выбранная интерполяция всегда лучше остальных способов увеличения.
| Операция | Что меняется | Где находятся обучаемые веса |
|---|---|---|
| ConvTranspose2d | Пространственный размер и число каналов | В ядре транспонированной свёртки |
| Resize → convolution | Сначала сетка интерполяции, затем признаки | В последующей обычной свёртке |
| Convolution → PixelShuffle | Каналы переставляются в пространственные позиции | В предшествующей свёртке; не в PixelShuffle |
Источник: Distill; определения ConvTranspose2d и PixelShuffle — документация PyTorch
Другой путь: сначала каналы, затем пространство
PixelShuffle, реализованный в PyTorch, не интерполирует значения и не обучает собственный фильтр. Он переставляет уже рассчитанные элементы тензора. Вход с C×r² каналами и размером H×W превращается в выход с C каналами и пространственным размером rH×rW. Здесь r — коэффициент увеличения. Число элементов при такой перестановке сохраняется: пространственная детализация появляется за счёт уменьшения количества каналов.
Официальный пример использует девять каналов, сетку 4×4 и коэффициент три. После PixelShuffle получается один канал размером 12×12. Это пример формы тензора из документации, а не измерение качества восстановления изображения. Чтобы получить цветную картинку, предшествующая часть сети должна рассчитать соответствующее число выходных каналов для её компонентов.
Само название sub-pixel convolution обычно относится ко всей конструкции: обучаемая свёртка подготавливает нужные каналы, а перестановка размещает их значения по пространственным позициям. Поэтому отсутствие обучаемых параметров у PixelShuffle не означает, что весь метод использует фиксированное увеличение. Обучение находится перед перестановкой; оператор лишь задаёт точное соответствие между каналами и положениями выходных пикселей.
Почему вычисления оставляют на низком разрешении
Архитектура ESPCN в работе Wenzhe Shi и коллег строится вокруг переноса основной обработки в пространство низкого разрешения. Авторы сопоставляют её с подходами, которые сначала увеличивают вход, например бикубической интерполяцией, а уже потом извлекают признаки на большой сетке. При увеличении обеих осей растёт число пространственных позиций, над которыми выполняется последующая свёртка.
В ESPCN промежуточные карты остаются компактными, а последний слой формирует набор каналов для периодической перестановки. Для коэффициента r он подготавливает r² пространственных фаз на каждый итоговый канал. Разные фазы соответствуют разным положениям внутри увеличенного участка. Сеть, следовательно, учит не один универсальный интерполяционный фильтр, а набор преобразований, связанных с положением выходного элемента.
Первичная публикация рассматривает восстановление отдельных изображений и видео. В её экспериментальной постановке модели обучались отдельно для каждого коэффициента увеличения. Получение результата высокого разрешения при этом остаётся задачей вывода по модели изображений: из одного низкокачественного входа нельзя единственным образом восстановить все исчезнувшие высокочастотные детали. Операция увеличения определяет размещение результата, но не превращает недостающую информацию в наблюдавшийся факт.
Геометрия увеличения и функция потерь решают разные задачи
Работа Justin Johnson, Alexandre Alahi и Fei-Fei Li о перцептивных потерях показывает другой уровень устройства преобразующей сети. Обучаемый генератор создаёт изображение, а заранее обученная и фиксированная сеть оценивает различия в признаках. Это отличается от попиксельного сравнения, которое может сильно штрафовать небольшое смещение, хотя зрительно картинки остаются похожими.
Для переноса стиля исследователи использовали признаки содержания и статистики стиля; для увеличения разрешения — сравнение признаков с целевым изображением без отдельной стилевой потери. Описанная архитектура включает остаточные блоки и слои, изменяющие пространственный размер. Уменьшение разрешения внутри сети позволяет увеличить эффективную область обзора, а обучаемое увеличение возвращает результат к необходимой сетке.
Таким образом, слой увеличения и критерий обучения отвечают на разные вопросы. Первый задаёт, как компактное представление разворачивается в пространстве; второй определяет, какие расхождения сеть стремится уменьшить. Более выразительная функция потерь сама по себе не меняет арифметику перекрытий. И наоборот, перестановка каналов или интерполяция со свёрткой не задают, что именно считать хорошей восстановленной текстурой. В архитектуре эти механизмы сосуществуют, а не заменяют друг друга.
Источники
- Odena et al. — Deconvolution and Checkerboard Artifacts ↗
- Dumoulin, Visin — A guide to convolution arithmetic for deep learning ↗
- PyTorch — ConvTranspose2d ↗
- PyTorch — PixelShuffle ↗
- Shi et al. — Efficient Sub-Pixel Convolutional Neural Network ↗
- Johnson et al. — Perceptual Losses for Real-Time Style Transfer and Super-Resolution ↗