Нейросети для графов: как узлы обмениваются сообщениями и почему порядок строк не должен менять ответ
Молекула, сеть цитирования и социальная связь имеют общую структуру, но не похожи на прямоугольную картинку. Разбираем message passing, GCN, GraphSAGE и графовое внимание по оригинальным работам.

Данные, у которых есть связи, но нет общей решётки
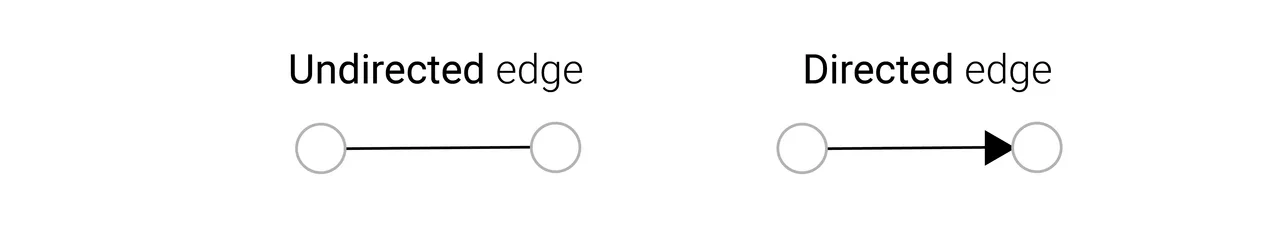
Граф задаётся узлами и соединяющими их рёбрами. У этих элементов могут быть собственные признаки: например, свойства атома и тип химической связи. Дополнительный вектор может описывать весь граф. В изложении Distill это три разных уровня данных, которые сеть способна преобразовывать. Причём соединения бывают направленными: тогда у ребра определены источник и получатель, а направление передачи информации имеет значение.
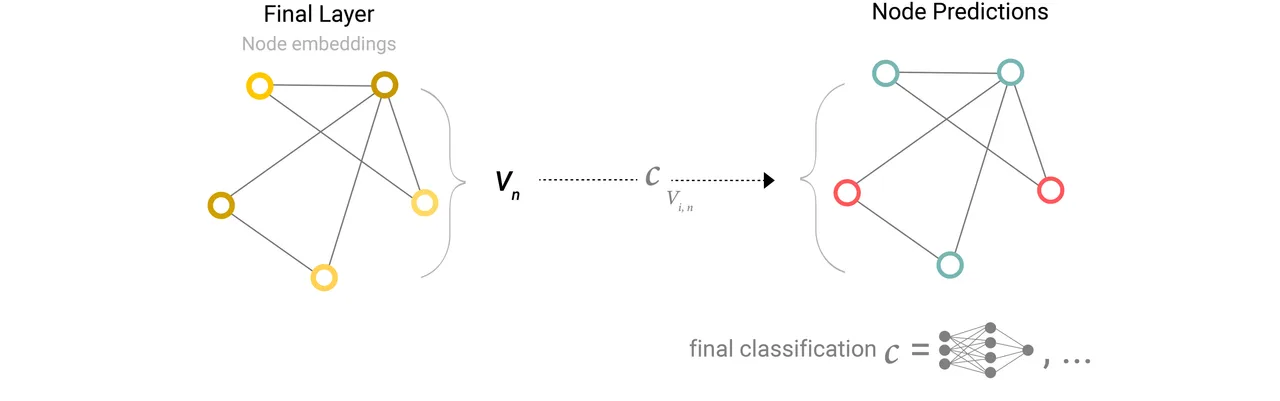
Прогноз тоже может относиться к разным уровням. Для узла можно определить категорию документа, для ребра — вероятность связи, для графа целиком — свойство молекулы. Изменение уровня ответа не означает, что требуется отказаться от графового представления. Нужен способ собрать подходящие признаки из узлов, рёбер или глобального контекста и передать их выходной части модели.
Простейший демонстрационный блок Distill независимо применяет небольшую нейросеть к каждому типу атрибутов. Он обновляет признаки, но ещё не использует соседство. Это важное различие: хранить данные в графе и извлекать информацию из связей — не одно и то же. Для второго требуется операция, которая переносит информацию между связанными элементами, а не просто преобразует каждую строку таблицы по отдельности.
Почему нельзя просто вытянуть граф в длинный вектор
В обычном изображении положение пикселя однозначно задаётся координатами. У произвольного графа нет такого естественного порядка узлов. Одну и ту же структуру можно записать с разной нумерацией, не изменяя сам объект. Если алгоритм принимает номера за содержательное свойство, он начинает различать эквивалентные описания одной сети связей.
В работе «Understanding Convolutions on Graphs» это формулируется как эквивариантность к перестановке: при перенумерации узлов их выходные представления должны переставиться соответствующим образом. Для ответа о графе целиком обычно нужна инвариантность: перестановка записей вообще не должна менять итог. Эти требования отличаются от произвольной перестановки связей, которая уже меняет исходный граф.
Ещё одна трудность — неодинаковое число соседей. У разных атомов, пользователей или документов оно различается, как различается и общее число узлов в примерах. Поэтому локальный фильтр нельзя механически перенести с фиксированного прямоугольного окна. Графовые слои используют повторно применяемые операции над соседством и агрегаторы переменного множества входов. При разреженных связях вычисления можно организовать через существующие рёбра, не создавая плотное взаимодействие каждой пары узлов.
Message passing: сообщение, обновление и общий ответ
В первичной работе Justin Gilmer и коллег Message Passing Neural Networks объединяют несколько ранее предложенных архитектур в общую схему. Прямой проход состоит из фазы обмена сообщениями и фазы считывания результата. На каждом шаге сообщение зависит от состояний связанных узлов и атрибутов ребра. Получатель собирает сообщения соседей и обновляет собственное скрытое состояние.
После нескольких шагов функция readout объединяет состояния узлов в вектор для всего графа. Для этого результата существенна независимость от порядка перечисления узлов. Сами функции сообщения, обновления и считывания задаются обучаемыми дифференцируемыми преобразованиями. Архитектура тем самым разделяет структуру обмена и параметры, которые определяют содержание переносимой информации.
В исследовании схема применялась к прогнозированию молекулярных свойств. Авторы отдельно рассматривали использование пространственной информации и работу только с топологией молекулы. Это разные входные условия: граф атомов и связей не тождественен известной трёхмерной конфигурации. Результаты исходной статьи относятся к её химическому набору данных и постановке обучения. Общая ценность MPNN здесь — язык описания вычислений, позволяющий сравнивать варианты через конкретные функции, а не считать все графовые сети одним алгоритмом.
GCN: нормированное смешивание признаков соседей
В модели Thomas Kipf и Max Welling графовая свёртка использует матрицу смежности вместе с признаками узлов. К связям добавляются самосвязи, чтобы при обновлении участвовало собственное представление узла. Затем нормировка учитывает степени узлов. Получившийся оператор переносит и смешивает признаки, после чего применяется обучаемая матрица весов.
Сочетание нескольких таких слоёв расширяет область доступной информации: следующий слой работает уже с представлениями, содержащими сведения от предыдущего окружения. Общие веса не зависят от конкретного номера узла. В описанной авторами полуконтролируемой постановке метки есть только у части документов, но структура графа и признаки могут участвовать в распространении информации для всех узлов.
В оригинальном двухслойном примере выходная функция потерь вычисляется по размеченным узлам. Это не требует считать все остальные узлы отрицательными или выдумывать им категории. При этом экспериментальная реализация использовала весь граф на каждой итерации обучения и разреженное представление смежности. Такой режим необходимо отличать от методов, специально рассчитанных на выборку небольших окрестностей и появление ранее не наблюдавшихся узлов. Это различие устройства обучения, а не просто другое название слоя.
GraphSAGE учит функцию для новых узлов
GraphSAGE, предложенный William Hamilton, Rex Ying и Jure Leskovec, ориентирован на индуктивное получение представлений. Вместо отдельного обучаемого вектора для каждого известного узла модель учит способ собирать признаки из локального окружения. Полученную функцию можно применить к новому узлу, если доступны необходимые признаки и связи.
На каждом уровне сначала агрегируются представления соседей, затем результат соединяется с собственным представлением узла и проходит через преобразование с нелинейностью. Повторение расширяет глубину доступного окружения. Исходная работа рассматривает разные агрегаторы, в том числе усреднение и pooling. Выбор агрегатора определяет, какая информация о множестве соседей сохраняется в компактном векторе.
Для пакетного обучения авторы используют выборку фиксированного числа соседей вместо полного обхода окружения. Это делает вычислительную нагрузку управляемой при узлах с большим количеством связей. Выборки могут меняться между итерациями. При этом число рассматриваемых элементов зависит от глубины и размеров выборок на уровнях: даже локальная схема не означает, что расширение окружения бесплатно. Важная особенность GraphSAGE — именно сочетание выборки и обучаемой агрегации, а не замена названия обычного усреднения.
| Подход | Основная операция | Особенность исходной работы |
|---|---|---|
| GCN | Нормированное распространение с самосвязями | Полуконтролируемая классификация узлов целого графа |
| GraphSAGE | Выборка соседей и обучаемый агрегатор | Индуктивное получение представлений новых узлов |
| GAT | Маскированное внимание внутри окружения | Зависящие от признаков коэффициенты разных соседей |
Источник: GCN, GraphSAGE и GAT: первичные публикации из списка источников
Графовое внимание задаёт разные веса соседям
В Graph Attention Networks Petar Veličković и коллег соседние узлы не обязаны вносить одинаковый вклад. После общего линейного преобразования признаков механизм внимания вычисляет оценку пары. Маска оставляет только допустимых соседей, включая сам узел в экспериментальной постановке авторов. Затем softmax нормирует оценки внутри этого окружения.
Обновлённое представление получается как взвешенная сумма преобразованных признаков. Вес зависит от содержания пары, а не только от наличия ребра или степени узла. Поэтому один и тот же сосед может иметь разное значение для разных получателей. Использование нескольких голов даёт несколько независимых вариантов такой агрегации; их результаты в промежуточных слоях объединяются.
Здесь внимание не отменяет графовую структуру. Напротив, исходная GAT использует её, чтобы определить, между какими элементами вообще рассчитываются коэффициенты. Если разрешить взаимодействие всех пар, это будет другая вычислительная постановка. GCN, GraphSAGE и GAT различаются не наличием скрытых векторов как таковых, а правилами их обновления: нормированным распространением, выборкой и агрегацией либо зависящими от признаков весами. Каждое из этих правил определяет, какую именно информацию сеть получает от своего окружения.
Источники
- Sanchez-Lengeling et al. — A Gentle Introduction to Graph Neural Networks ↗
- Daigavane et al. — Understanding Convolutions on Graphs ↗
- Gilmer et al. — Neural Message Passing for Quantum Chemistry ↗
- Kipf, Welling — Semi-Supervised Classification with Graph Convolutional Networks ↗
- Hamilton et al. — Inductive Representation Learning on Large Graphs ↗
- Veličković et al. — Graph Attention Networks ↗