VocabX меняет словарь малой модели, чтобы сократить стоимость ответа
Dharma AI показала эксперимент с проверкой португальских эссе. Заявленные 77% относятся к одному производственному сценарию, а статья ещё готовится.
Экономия начинается до генерации
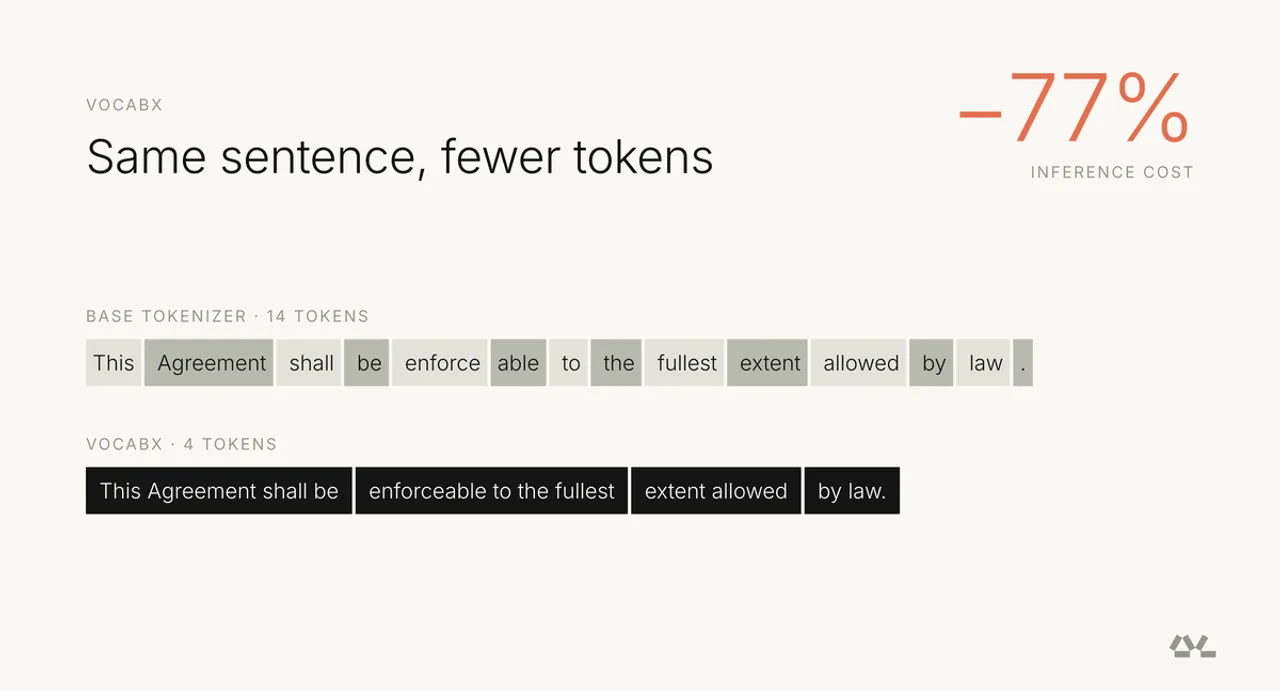
Dharma AI описала VocabX — способ специализации словаря небольшой языковой модели под повторяющийся рабочий сценарий. В опубликованном случае Qwen3-4B оценивала эссе на португальском и возвращала структурированное заключение. Универсальный токенизатор делил часто повторявшиеся имена полей и стандартные фразы на множество частей. Каждая такая часть требовала очередного шага генерации. Авторы переработали словарь с учётом вычислительной цены записи текста, сохранив базовую модель и рецепт обучения. В этом конкретном измерении средний ответ сократился с 350 до 101 токена, а стоимость инференса — на 77 процентов. Число не относится к любому запросу, языку или провайдерскому тарифу.
Не только сжатие последовательности
У словаря есть две связанные цены: сколько токенов занимает ответ и сколько вариантов система оценивает на каждом шаге. Сокращение последовательности способно уменьшить число последовательных вычислений, а сокращение выходного словаря — объём финального выбора. Однако простая замена частых выражений одним обозначением не всегда сохраняет качество. В эксперименте первоначальная версия объединила оценку и окружающий JSON в один крупный токен; итоговый показатель ухудшился. Разделение содержательной оценки и шаблона вернуло модели возможность принимать решение отдельно. Этот пример показывает, почему минимальная длина записи и удачная модель задачи не тождественны. Цифры в публикации предварительные: работа VocabX на дату материала ещё готовилась и могла измениться до публикации.
Как метод связан с предыдущими исследованиями
Задача переноса словаря имеет исследовательскую историю. Работа Fast Vocabulary Transfer for Language Model Compression рассматривает изменение словаря как часть сжатия языковой модели. Более новое исследование In-Place Tokenizer Expansion изучает расширение токенизатора предварительно обученной модели. Эти направления помогают разделить три операции: изменение разбиения текста, изменение набора входных и выходных представлений и последующее обучение. Добавить токен в файл токенизатора недостаточно, чтобы существующие веса сразу научились надёжно понимать и выдавать его. В специализированном применении также нужно сохранить различия, на которых строится само решение: числа, категории, отрицания и значимые границы полей. Иначе компактная форма лишь прячет потерю информации.
Что пока остаётся открытым
Блог даёт описание производственного примера и сравнения на нескольких предметных корпусах, но ещё не заменяет полного исследовательского отчёта с окончательными таблицами. Нельзя по одному проценту восстановить стоимость подготовки нового словаря, объём обучения и перенос результата на другую длину ответа. Для приложения с короткими метками экономия будет устроена иначе, чем для длинного комментария; изменится и соотношение затрат на чтение и запись. При смене токенизатора нужны согласованные файлы модели и обработчика текста: смешение старого клиента с новым набором весов нарушает представление данных. VocabX интересен как измеренный частный результат и продолжение существующей линии исследований. На 30 октября его следует читать с явной оговоркой о предварительном характере, а не как уже подтверждённый общий способ снизить любой счёт на 77 процентов.