StateBench проверяет, помнит ли ИИ актуальные факты после длинной цепочки изменений
Ai2 представил тест с четырьмя уровнями сложности: найти значение, учесть перезапись, накопить изменения или проследить зависимости. Длина контекста сама по себе не гарантирует верный итог.
Длинный текст и меняющиеся данные — разные испытания
3 ноября Ai2 представил StateBench — набор задач для проверки того, как языковые модели отслеживают состояние объектов в длинных последовательностях. Научная работа появилась на arXiv 2 ноября. Поводом для публикации стал новый тест и его открытые материалы, а не выход новой потребительской модели или сервиса памяти.
Тест отличается от простого поиска упоминания в документе. Если значение сначала записали, затем изменили, а позже скопировали в другую переменную, одного нахождения последней похожей строки недостаточно. Нужно восстановить цепочку операций. Авторы разделяют эти ситуации по вычислительной сложности, чтобы не смешивать успешный поиск факта с умением последовательно применять изменения к уже известным данным.
Четыре уровня вместо одного общего балла
Иерархия исследования начинается с неизменяемого присваивания: значение записывается один раз. Следующий уровень разрешает перезапись конкретным значением. Далее появляются операции, использующие предыдущее состояние самой переменной. Самый сложный класс добавляет зависимости между переменными, включая перестановки их значений.
В статье эта градация связывается с формальной теорией конечных моноидов. Для читателя практическое различие проще: найти запись, выбрать последнюю запись и вычислить результат многих связанных шагов — не одно действие. Теоретические утверждения относятся к заданным архитектурам, точности вычислений и постановкам задач. Их нельзя превращать в универсальный приговор любому продукту, использующему Transformer, независимо от внешних инструментов и способа работы.
Как устроена воспроизводимая проверка
Открытый репозиторий объясняет, как из одной исходной последовательности получают связанные семейства примеров. Данные содержат идентификаторы исходного примера, поэтому варианты можно сопоставлять между собой. Генератор сохраняет общие условия и меняет смысл разрешённых обновлений, а не просто сравнивает четыре случайных набора разной длины.
Важна семантика копирования: присваивание a ← b переносит текущее значение b в этот момент, но не создаёт постоянную связь между двумя переменными. Репозиторий также описывает форматы кода, ячеек таблицы, сигнальных индикаторов и перемещения людей между комнатами. Один механизм может выглядеть по-разному в тексте, что позволяет отдельно исследовать чувствительность модели к форме представления задачи.
Генератор предусматривает и варианты с выбором ответа: к правильному конечному состоянию добавляются четыре неверных, а порядок перемешивается. Такой формат отделён от свободной генерации итоговых значений: эти способы оценки нельзя автоматически считать одним и тем же экспериментом.
Что показали эксперименты и где проходят границы
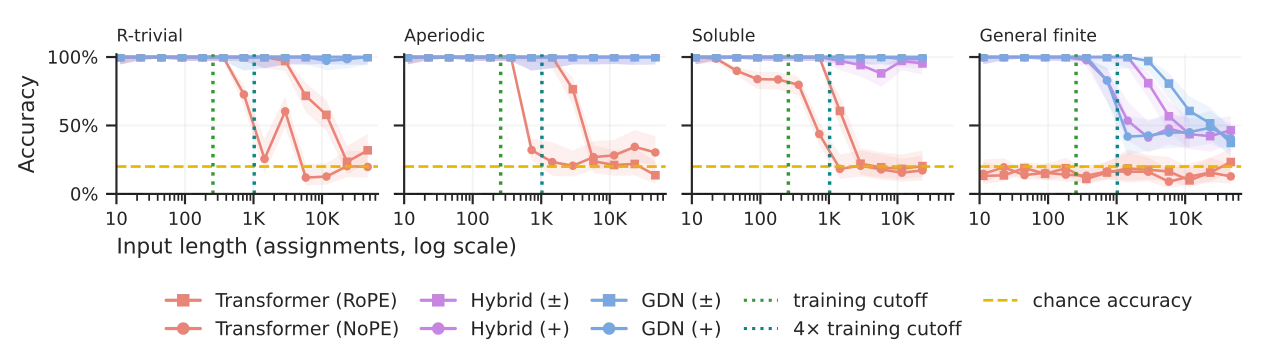
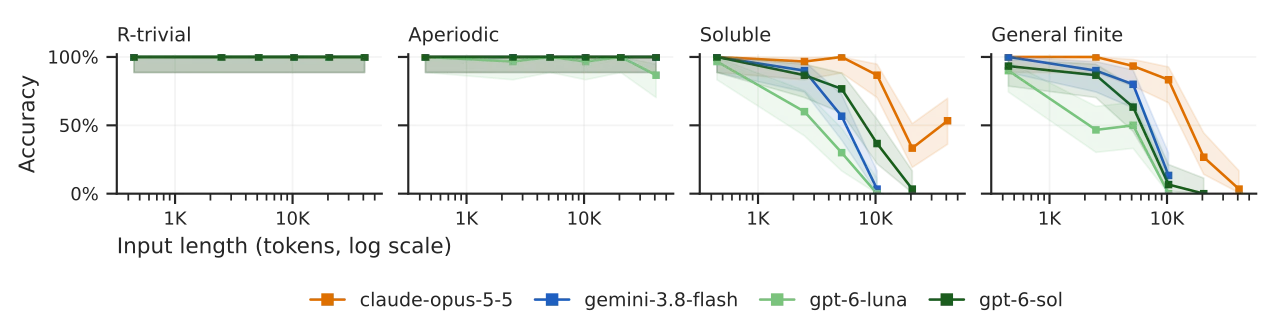
Авторы проверяли как предварительно обученные модели, так и небольшие архитектуры, обученные непосредственно на StateBench. Это разные условия эксперимента: удачный результат специального обучения не означает, что готовый универсальный помощник уже обладает той же способностью. Для сложных длинных последовательностей качество исследованных передовых моделей заметно снижалось.
Исследование использует фиксированное число переменных. Реальный диалог, где появляются новые люди, документы и объекты, не полностью укладывается в такую схему. В открытом коде предусмотрена проверка пересечения обучающих и тестовых примеров по семантическим идентификаторам; повторяемость генерации отделяется от самого результата модели. Опубликованный график показывает измерения авторов, а не наш запуск теста. Полные условия, данные и код нужны для корректного сопоставления, а не для составления общего рейтинга любых ИИ-помощников.