SenseTime выпустила SenseNova Loop-9B с повторным проходом через слои декодера
Версия от 17 ноября принимает текст и изображения. Два прохода через средний блок помогают увеличить вычислительную глубину, а расход памяти зависит от длины контекста и формата кэша.
Финальный выпуск после Preview
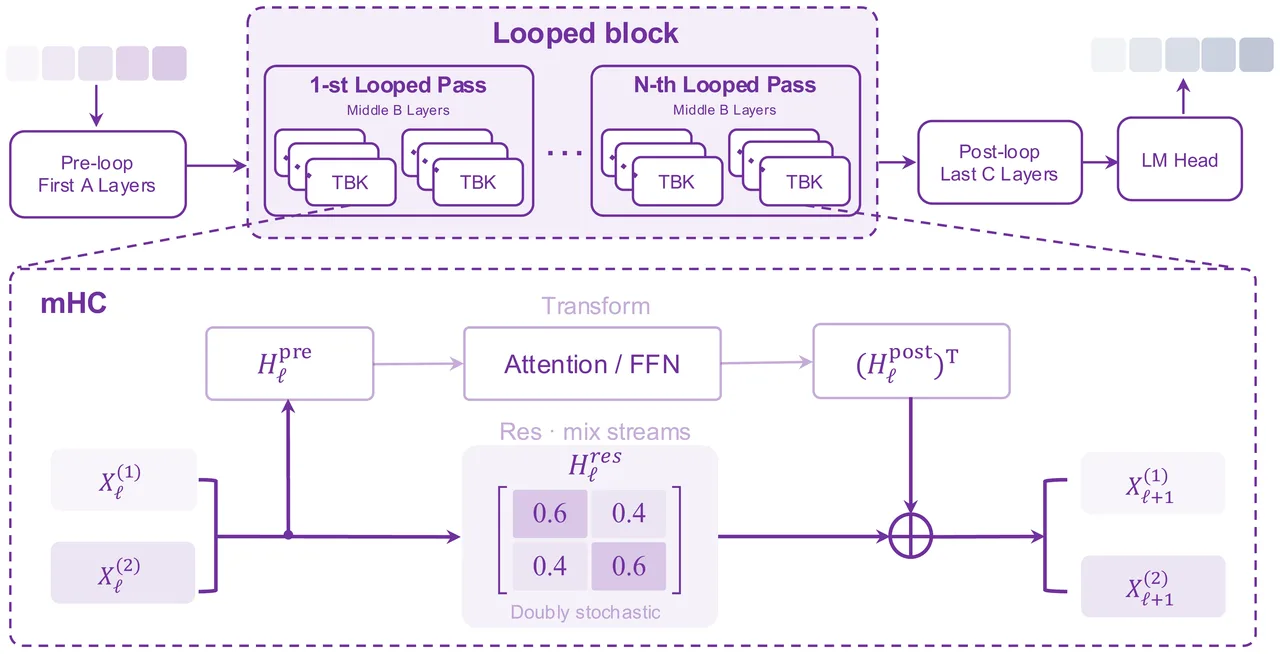
SenseTime 17 ноября выпустила SenseNova Loop-9B, модель с открытыми весами для работы с текстом и изображениями. Предварительная версия появилась 31 октября. У финальной сохранились повторное использование весов среднего блока и двухпоточные остаточные соединения, а изменения затронули качество выполнения ряда задач. Это выпуск конкретной версии модели, поэтому результаты старой Preview следует сверять отдельно, даже если имя архитектуры в конфигурации осталось прежним. Исходная раздача включает веса BF16 в формате Safetensors. На следующий день официальный репозиторий добавил ссылки на четырёхбитную сборку AWQ и варианты GGUF.
Как устроен повторный проход
У декодера 32 различных слоя, но за один прямой проход они выполняются 56 раз. Средний блок из 24 слоёв проходит вход дважды, причём параметры этих слоёв общие. Во второй проход блок получает уже изменённое внутреннее состояние, так что его вклад отличается от первого применения. Увеличение глубины таким способом не требует ещё 24 отдельных наборов весов. Однако арифметику второго прохода всё равно приходится выполнять, и компактный файл не устраняет её влияние на задержку. Для оценки локальной работы полезно разделять загрузку весов, обработку длинного входа и последующую генерацию, поскольку у этих этапов разные ограничения.
Размер весов и память устройства
В описании проекта указаны около девяти миллиардов параметров, контекст до 512 тысяч токенов и около 4,9 ГБ для четырёхбитных весов. Последняя величина относится к самим весам. При генерации нужны промежуточные данные и кэш ключей и значений внимания, который растёт с длиной уже обработанного контекста. Для контекста в 64 тысячи токенов авторы оценивают потребность примерно в 9 ГиБ с четырёхбитным кэшем и в 10 ГиБ с восьмибитным. Для 256 тысяч токенов соответствующие оценки составляют около 12 и 15 ГиБ. В таблице нет аналогичной оценки для предельных 512 тысяч, поэтому верхний предел контекста сам по себе не описывает пригодность конкретной видеокарты.
Что показывают тесты и что проверять отдельно
В опубликованной таблице модель близка к Qwen3.8-27B на отдельных задачах, но порядок меняется от набора к набору. Например, у SenseNova результат на NL2Repo ниже, а на AIDABench в приведённом авторами сравнении результаты близки. Это тесты разработчика, и они не устанавливают средний выигрыш на произвольных пользовательских запросах. В разделе ограничений прямо названы нестабильное выполнение длительных задач и потеря отдельных требований при сложных многошаговых инструкциях. Для команды, которая сравнивает модель с уже используемой, полезно прогнать собственные документы и изображения, замерить задержку ответа при типичном объёме входа и проверить, сохраняются ли результаты при переходе с BF16 на выбранную квантизацию. Разница в формате вычислений и в ветке среды запуска может оказаться столь же заметной, как разница между моделями. Поддержка специализированной архитектуры в движках развёртывания также зависит от версии: инструкции проекта ссылаются на отдельные ветки и изменения, поэтому наличие общего загрузчика GGUF ещё не подтверждает совместимость с этой моделью.