OpenTelemetry Collector: чем агент отличается от шлюза и как телеметрия проходит по конвейеру
Получить данные, преобразовать их и отправить в систему наблюдаемости — три отдельные операции. Устройство Collector объясняет, почему объявленный компонент ещё не включён, а очередь в памяти не равна гарантированному хранению.
Collector — промежуточная обработка, а не хранилище всех сигналов
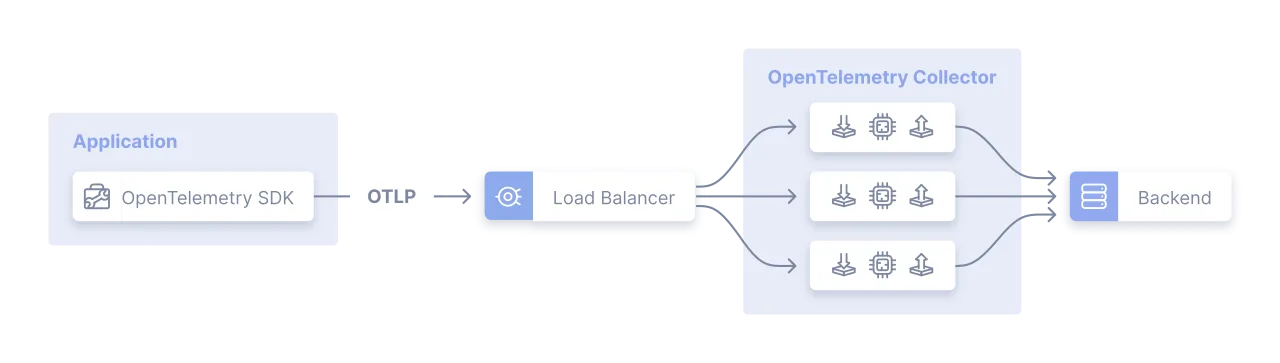
OpenTelemetry Collector принимает телеметрию, обрабатывает её и экспортирует в назначенные системы. Он позволяет отделить код инструментализации приложения от особенностей конечных платформ наблюдаемости. Приложение может передавать данные через OTLP, а дальнейшая маршрутизация и подготовка происходят в отдельном процессе.
Это не делает Collector обязательным для каждого учебного примера. Документация допускает прямую отправку из SDK в backend для начала работы и небольших окружений. При вынесении промежуточной обработки в Collector приложение может быстрее передать телеметрию и не управлять самостоятельно каждым последующим действием — повторной отправкой, пакетированием или фильтрацией. При этом конечная система хранения и анализа остаётся отдельным компонентом.
Collector имеет расширяемую архитектуру и разные дистрибутивы с наборами компонентов. Общая зрелость не распространяется автоматически на каждую интеграцию: статус конкретного receiver, processor или exporter указывается отдельно. Поэтому два процесса с общим названием Collector не обязательно содержат одинаковые поддерживаемые протоколы. Способность принять сигнал и дальнейшее назначение зависят от реально включённых компонентов сборки и конфигурации, а не только от установленного исполняемого файла.
Конвейер задаёт путь данных и порядок преобразований
Внутренний pipeline состоит из receivers, последовательности необязательных processors и exporters. Получатель принимает данные по сети или собирает их активным опросом. Процессор преобразует, фильтрует либо отбрасывает данные. Экспортёр передаёт результат наружу. Несколько выходов могут получить собственные копии одного элемента через разветвление в конце конвейера.
Тип сигнала относится к конкретному pipeline. Компоненты должны поддерживать этот тип: наличие приёмника трассировок не означает возможность использовать его тем же способом для метрик. При загрузке конфигурации неподдерживаемое сочетание становится ошибкой. Такой контракт позволяет разделять пути traces, metrics и logs в одном процессе.
Один receiver может передавать данные нескольким конвейерам. С процессорами тонкость другая: одинаковое имя в нескольких pipelines использует одну конфигурацию, но отдельные экземпляры со своим состоянием. Таким образом, указание одного имени не обязательно означает общее состояние обработки. Порядок последовательных процессоров имеет значение, поскольку каждый получает результат предыдущего. Удалённый атрибут не появляется заново только из-за того, что следующий этап рассчитывает другой показатель.
Объявить компонент и подключить его — разные действия
Конфигурация разделяет описание экземпляров и их использование. Секции receivers, processors, exporters и connectors задают параметры. Раздел service включает нужные компоненты в pipelines. Если экспортёр объявлен, но ни один активный маршрут его не использует, сам факт присутствия настроек не запускает отправку.
Имена допускают форму type/name: так можно завести несколько экземпляров одного типа с разными назначениями. Extensions подключаются отдельно и обеспечивают служебные возможности, например диагностику. Они не обязаны участвовать в непосредственном преобразовании каждого элемента телеметрии. Collector также имеет команду проверки конфигурации до обычного запуска.
Connectors связывают два конвейера, выступая экспортёром на выходе одного и получателем на входе другого. Это позволяет, например, получить метрику из событий трассировки. Обычный процессор внутри traces pipeline не превращается от одного переименования в выход metrics pipeline. Важны и типы сигналов, и граница маршрутов. В результате конфигурация описывает не просто список плагинов, а конкретный граф передачи и обработки, в котором каждый компонент получает определённую роль.
| Компонент | Действие | Где включается |
|---|---|---|
| Receiver | Принимает или собирает сигнал | В начале pipeline |
| Processor | Меняет или фильтрует сигнал | В упорядоченной середине pipeline |
| Exporter | Отправляет данные назначению | В конце pipeline |
| Connector | Связывает два pipelines | Как exporter одного и receiver другого |
| Extension | Добавляет служебную возможность | В service.extensions |
Источник: OpenTelemetry Collector configuration
Агент размещается рядом с источником
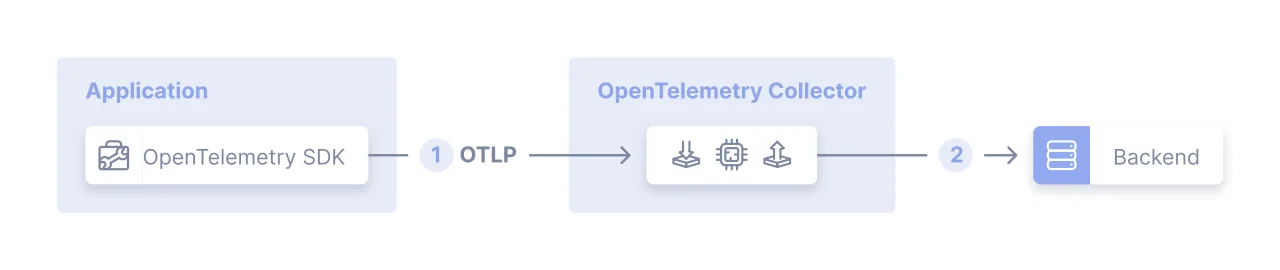
В агентском шаблоне экземпляр Collector работает рядом с приложением или на том же хосте. Документация приводит варианты sidecar и DaemonSet. SDK направляет OTLP в близкий Collector, который затем отправляет данные в одну или несколько систем. Это локальное размещение, а не отдельный вид телеметрического протокола.
Близость к источнику даёт понятное соответствие между приложением, машиной и точкой приёма. Настройки конечной платформы можно сосредоточить в Collector, не меняя код приложения для каждого направления. Однако число агентских процессов и их конфигураций растёт вместе с окружением, а сложная централизованная обработка не возникает автоматически из множества независимых агентов.
Поток может поступать не только от SDK, но и от другого Collector. Поэтому термин «агент» описывает прежде всего место процесса в схеме развёртывания и его связь с источником. Один и тот же механизм pipelines остаётся применимым. Локальный агент также может стать первым этапом более длинной цепочки, где часть обработки выполняется централизованно, а не завершается непосредственной отправкой в конечное хранилище.
Шлюз объединяет поток, но обработке иногда нужна привязка
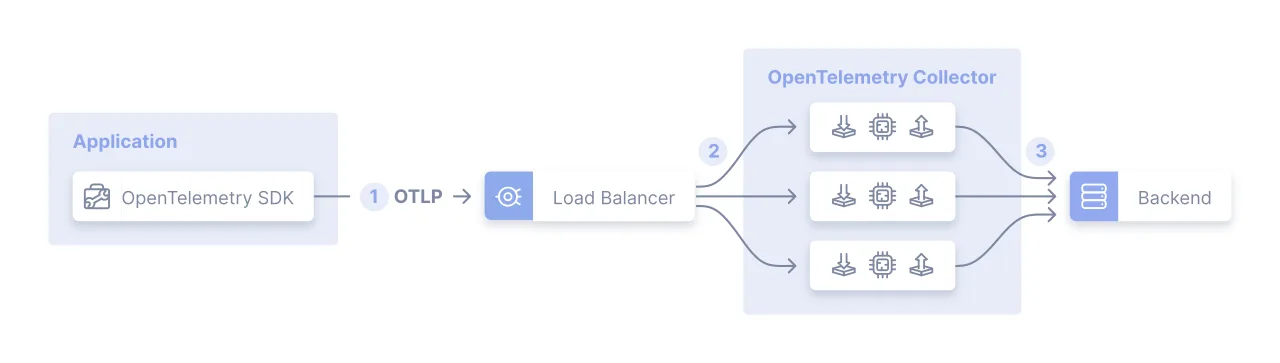
Gateway принимает телеметрию на общий OTLP endpoint от приложений или других Collectors. За адресом может находиться несколько экземпляров сервиса, например развёрнутых в одном кластере или регионе. В простой схеме внешний балансировщик распределяет поступающие данные между репликами, которые отправляют их дальше.
Не вся обработка допускает случайное распределение отдельных частей. Для tail sampling требуется собрать spans одной трассировки у соответствующего обработчика. Документация поэтому показывает двухуровневую схему: первый слой Collectors использует load-balancing exporter с учётом Trace ID, а второй выполняет обработку согласованного потока. Подпись Load Balancer на такой схеме обозначает роль первого Collector, а не обязательно внешний сетевой прибор.
Различие важно и для понимания масштабирования. Добавление реплик увеличивает число получателей, но само по себе не задаёт, какие элементы должны встретиться вместе. Для метрик дополнительно учитывается принцип единственного производителя соответствующего потока. Поэтому gateway — это способ организовать общий вход и управляемую маршрутизацию, а не обещание, что произвольная копия конфигурации делает любой stateful-процессор горизонтально независимым.
Очередь переживает разные отказы по-разному
Когда конечный endpoint недоступен, экспортёр может удерживать данные в sending queue и повторять отправку с задержкой. Память даёт буфер для временной проблемы, но имеет конечный размер. При заполнении очереди или превышении настроенного срока повторов часть данных может быть отброшена. Размер очереди не равен гарантированно выдерживаемому времени простоя: важны также скорость поступления и объём элементов.
Для переживания перезапуска самого Collector предусмотрено постоянное хранилище очереди через file_storage. Данные записываются в журнал на диске, затем после старта процесс продолжает попытки передачи. Это защищает от другого класса отказов, чем буфер в оперативной памяти. Включение расширения и ссылка на него в очереди экспортёра — связанные, но отдельные части конфигурации.
Постоянная очередь не отменяет возможный отказ диска, исчерпание места или ограничения повторной отправки. Документация также рассматривает отдельные очереди сообщений как ещё один архитектурный элемент. Эти механизмы различаются границей ответственности: Collector управляет доставкой телеметрии по своему маршруту, а конечный backend хранит и предоставляет её для анализа. Наблюдаемость самого процесса и его очередей поэтому относится к устройству всей цепочки, а не только к работоспособности приложения-источника.