Один Ceph — три интерфейса: как RADOS размещает данные для объектов, дисков и файлов
Облачный том и общий файловый каталог могут храниться в одном распределённом объектном ядре. Разбираем роли OSD и monitors, группы размещения, карту отказов, erasure coding и метаданные CephFS.

Объектное ядро не ограничивает систему объектным API
В архитектуре Ceph общий слой RADOS хранит данные как объекты, а поверх него работают разные клиентские интерфейсы. Приложение может использовать объектный доступ, блочный диск RBD или файловую систему CephFS. Эти способы обращения задают разную семантику, хотя нижележащее распределённое хранение остаётся общим.
OSD управляют чтением, записью и избыточным размещением данных на накопителях. Monitors поддерживают основные карты кластера и предоставляют их клиентам. Manager выполняет задачи мониторинга, оркестрации и подключаемых модулей. MDS необходим для файловых метаданных CephFS, а не как обязательный центральный посредник для каждого объектного запроса.
Клиенты и OSD используют CRUSH для вычисления размещения. Это отличается от поиска каждого объекта в единой центральной таблице адресов. При этом отсутствие такого справочника не означает отсутствие служебного состояния: карты и согласованная информация о кластере остаются важной частью системы. Разбор опирается на документацию ветки Reef и описывает архитектурные принципы, а не объявляет эту ветку новой или предпочтительной версией для развёртывания в 2026 году.
Группа размещения связывает объекты с OSD
Внутри логического pool объекты распределяются по placement groups. Каждый RADOS-объект относится к определённой PG, а каждая PG — к одному pool. Система управляет размещением и восстановлением на уровне таких групп, а не держит независимое решение о размещении для каждого из множества объектов.
Число PG связано с балансом данных и затратами управления. Документация описывает autoscaler, который учитывает наблюдаемое и ожидаемое использование pools и может рекомендовать либо автоматически менять число групп. Режимы off, on и warn различают ручное управление, автоматическое изменение и выдачу предупреждений. Это разные политики эксплуатации одного механизма, не разные типы данных.
В оценках использования различаются полезный размер и занятое сырое пространство с учётом избыточности. Pool с репликами и pool с кодированными фрагментами имеют разный коэффициент расхода. Прогнозируемая доля данных также может задаваться явно. Поэтому один показатель числа PG без сведений о составе pools и выбранной схеме защиты не описывает весь план размещения. Группа — промежуточный уровень между семантикой объекта и физическим множеством устройств, на котором согласуется работа кластера.
CRUSH учитывает не только диски, но и общие причины отказа
Карта CRUSH содержит OSD, иерархию контейнеров и правила. Контейнеры могут отражать хосты, стойки, помещения и другие уровни физического размещения. Правило определяет, по каким частям этой иерархии распределять реплики или кодированные фрагменты. Поэтому два разных диска не всегда считаются достаточно независимыми местами хранения.
Если оба находятся в одном сервере, отказ его питания затронет их одновременно. Аналогично несколько серверов могут зависеть от общей стойки или сетевого оборудования. Failure domain задаёт уровень, на котором система должна разносить нужные части данных. Такое описание должно соответствовать действительной инфраструктуре: алгоритм использует предоставленную карту, а не самостоятельно узнаёт электрическую схему дата-центра.
В документированных настройках местоположение OSD выражается парами ключей и значений, например host и rack. Изменение карты может менять рассчитанное размещение. Сам CRUSH отвечает за детерминированный выбор с учётом политики, а не за прикладное содержимое объектов. Защита от общего отказа возникает из сочетания реальной топологии, корректной карты и достаточного числа доступных доменов, а не только из факта включения нескольких накопителей в общий pool.
Репликация и erasure coding сохраняют избыточность по-разному
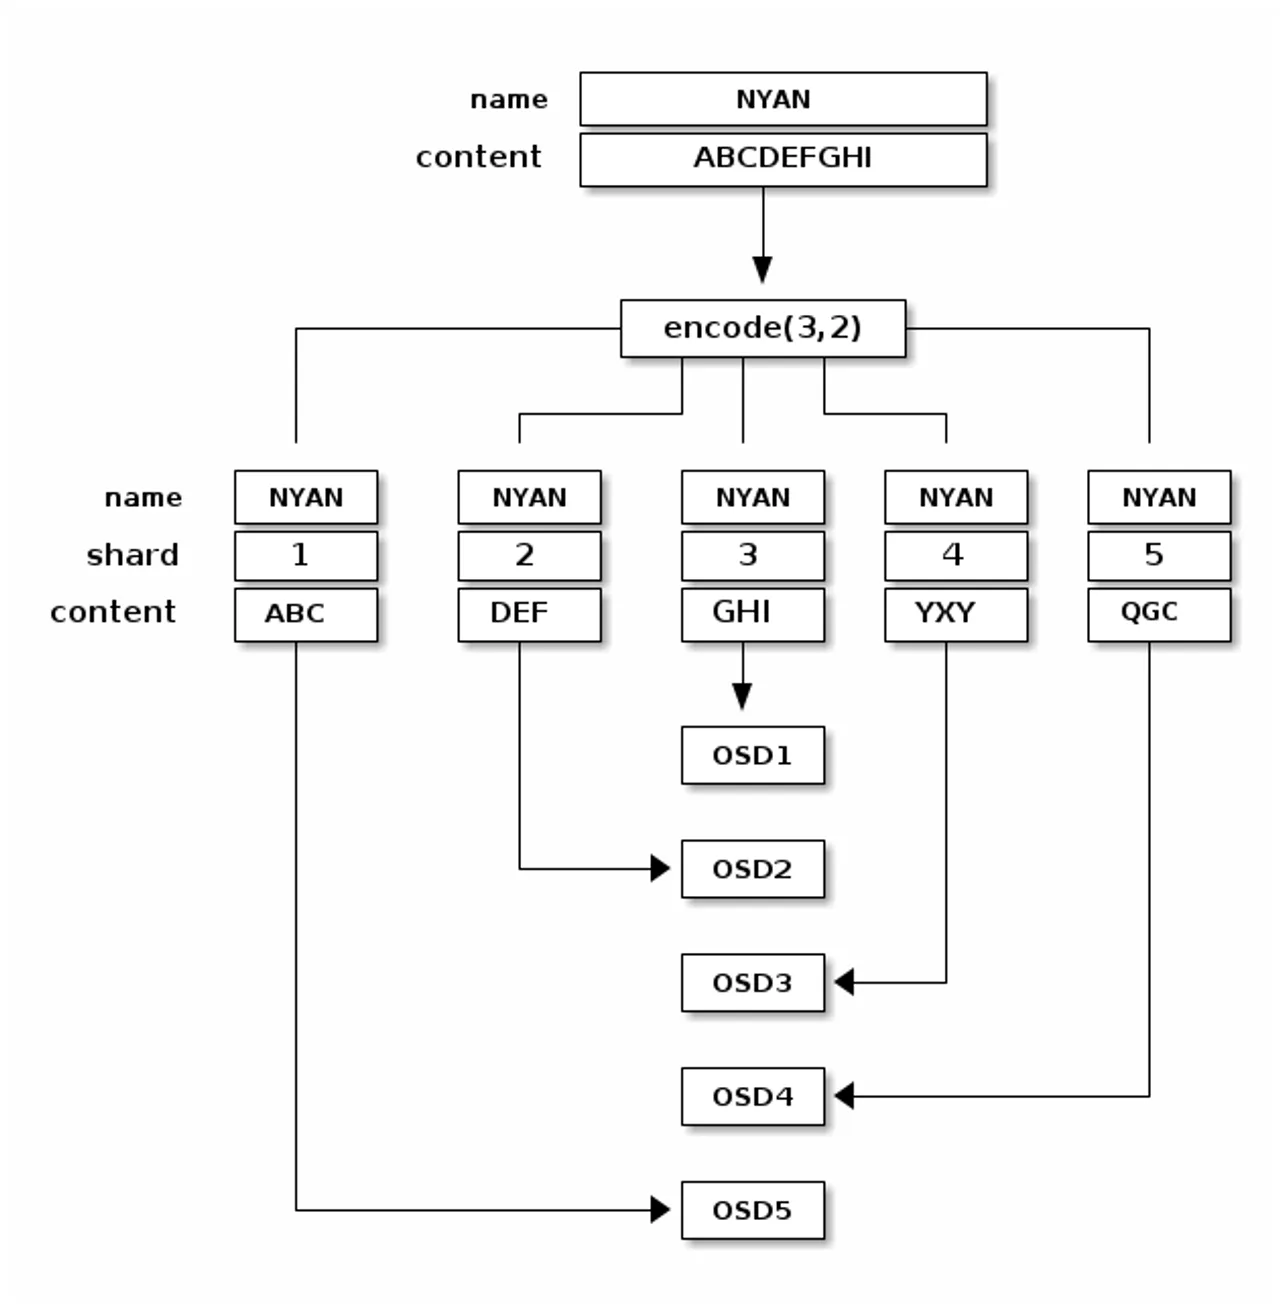
Реплицируемый pool хранит несколько копий объекта. Erasure-coded pool делит его на data chunks и coding chunks, позволяющие восстановление при потере части фрагментов. Числа K и M задают соответственно количество фрагментов данных и дополнительных кодирующих частей. Они определяют структуру избыточности, а правило CRUSH — их физическое распределение.
В примере документации K=3 и M=2 объект разбивается на три части данных и дополняется двумя кодирующими частями. При размещении по стойкам правило не кладёт два таких фрагмента в одну стойку. Это иллюстрация профиля и отказных доменов, а не измерение производительности кластера. Экономия полезной ёмкости относительно полного копирования сопровождается другой структурой операций восстановления.
В ветке Reef отдельно оговорены частичные перезаписи: для использования таких pools под данными RBD и CephFS требуется соответствующий режим на BlueStore. Метаданные, которым нужен omap, размещаются в реплицируемых pools. Поэтому выбор EC для части данных не означает, что вся связанная служба автоматически становится полностью erasure-coded. Прикладной интерфейс и требования к метаданным по-прежнему влияют на состав используемых pools.
RBD добавляет семантику блочного образа и снимков
RBD предоставляет блочный образ поверх распределённого слоя. Его snapshot — логическое read-only состояние на определённый момент. Из снимка можно создавать copy-on-write clones, что подходит, например, для множества виртуальных машин с общим исходным образом. Клон не обязательно требует немедленного полного копирования всех данных базового диска.
Однако RBD не знает внутреннюю файловую систему гостя. Несогласованный с ней снимок имеет crash-consistent характер: он фиксирует состояние блочного устройства, но не гарантирует завершение прикладных транзакций. Документация поэтому отделяет создание snapshot от подготовки операционной системы и допускает координацию через guest agent.
Rollback перезаписывает текущее состояние образа данными снимка; это отличается от создания нового клона. Удаление snapshot также не означает мгновенное освобождение всех нижележащих данных: соответствующая очистка выполняется асинхронно. Эти особенности относятся к жизненному циклу блочного интерфейса. Они не меняют того, что на нижнем уровне данные распределены по объектам RADOS, но показывают, какие дополнительные правила появляются, когда объектное ядро используется в качестве диска виртуальной машины.
CephFS разделяет доступ к данным и согласование метаданных
CephFS предоставляет файловую модель с каталогами и POSIX-семантикой поверх RADOS. Метаданные файлов и сами данные хранятся в отдельных pools. MDS обслуживают сведения о структуре и состоянии файлового пространства, тогда как клиенты читают и записывают блоки данных непосредственно через RADOS. Нет необходимости передавать каждый байт файла через центральный файловый шлюз.
Клиенты и MDS совместно поддерживают согласованный распределённый кэш метаданных. Изменения агрегируются и журналируются в RADOS; MDS не делает собственный локальный диск единственным постоянным источником этой информации. Масштабирование метаданных при этом представляет отдельную задачу от увеличения ёмкости OSD.
Таким образом, общая база хранения не стирает различия интерфейсов. RBD предоставляет дисковое адресное пространство и операции над образами. CephFS организует файлы, каталоги и метаданные. Объектный доступ работает со своей моделью объектов. Разделение видно и в наборе демонов, и в размещении служебных данных. Оно позволяет использовать единое распределённое ядро, сохраняя разные способы описания и согласования информации для приложений, виртуальных машин и файловых клиентов.

| Интерфейс | Что видит приложение | Дополнительная семантика |
|---|---|---|
| Объектный | Объекты | Операции объектного интерфейса |
| RBD | Блочный образ | Снимки и copy-on-write clones |
| CephFS | Файлы и каталоги | POSIX и согласованные метаданные через MDS |
Источник: Ceph: Architecture, RBD Snapshots и Ceph File System