AMD ZenDNN 6.1 расширила CPU-инференс: attention, MoE и кэш весов
Открытая библиотека обновляет вычислительные ядра для языковых моделей. Объясняем, чем низкоуровневый LowOHA отличается от установки обычного приложения с ИИ.
Библиотека вычислений, а не новая модель
4 ноября AMD опубликовала ZenDNN 6.1.0 — библиотеку операций для выполнения нейросетей на CPU. Выпуск продолжает низкоуровневый стек LowOHA и расширяет операции, востребованные языковыми моделями. Это не новый процессор и не программа, которая сама скачивает модель и открывает чат: библиотеку подключают разработчики вычислительных сред и интеграций.
В release notes перечислены изменения матричных умножений, attention, моделей Mixture-of-Experts, квантования и хранения подготовленных весов. Для group matmul добавлены ядра FP16 и DA8W4. Для attention указаны GQA и вариант со скользящим окном. При этом опубликованный список возможностей не заменяет измерение на конкретной модели, процессоре и наборе входных данных. Собственных чисел ускорения эта публикация не содержит.
Зачем нужен LowOHA
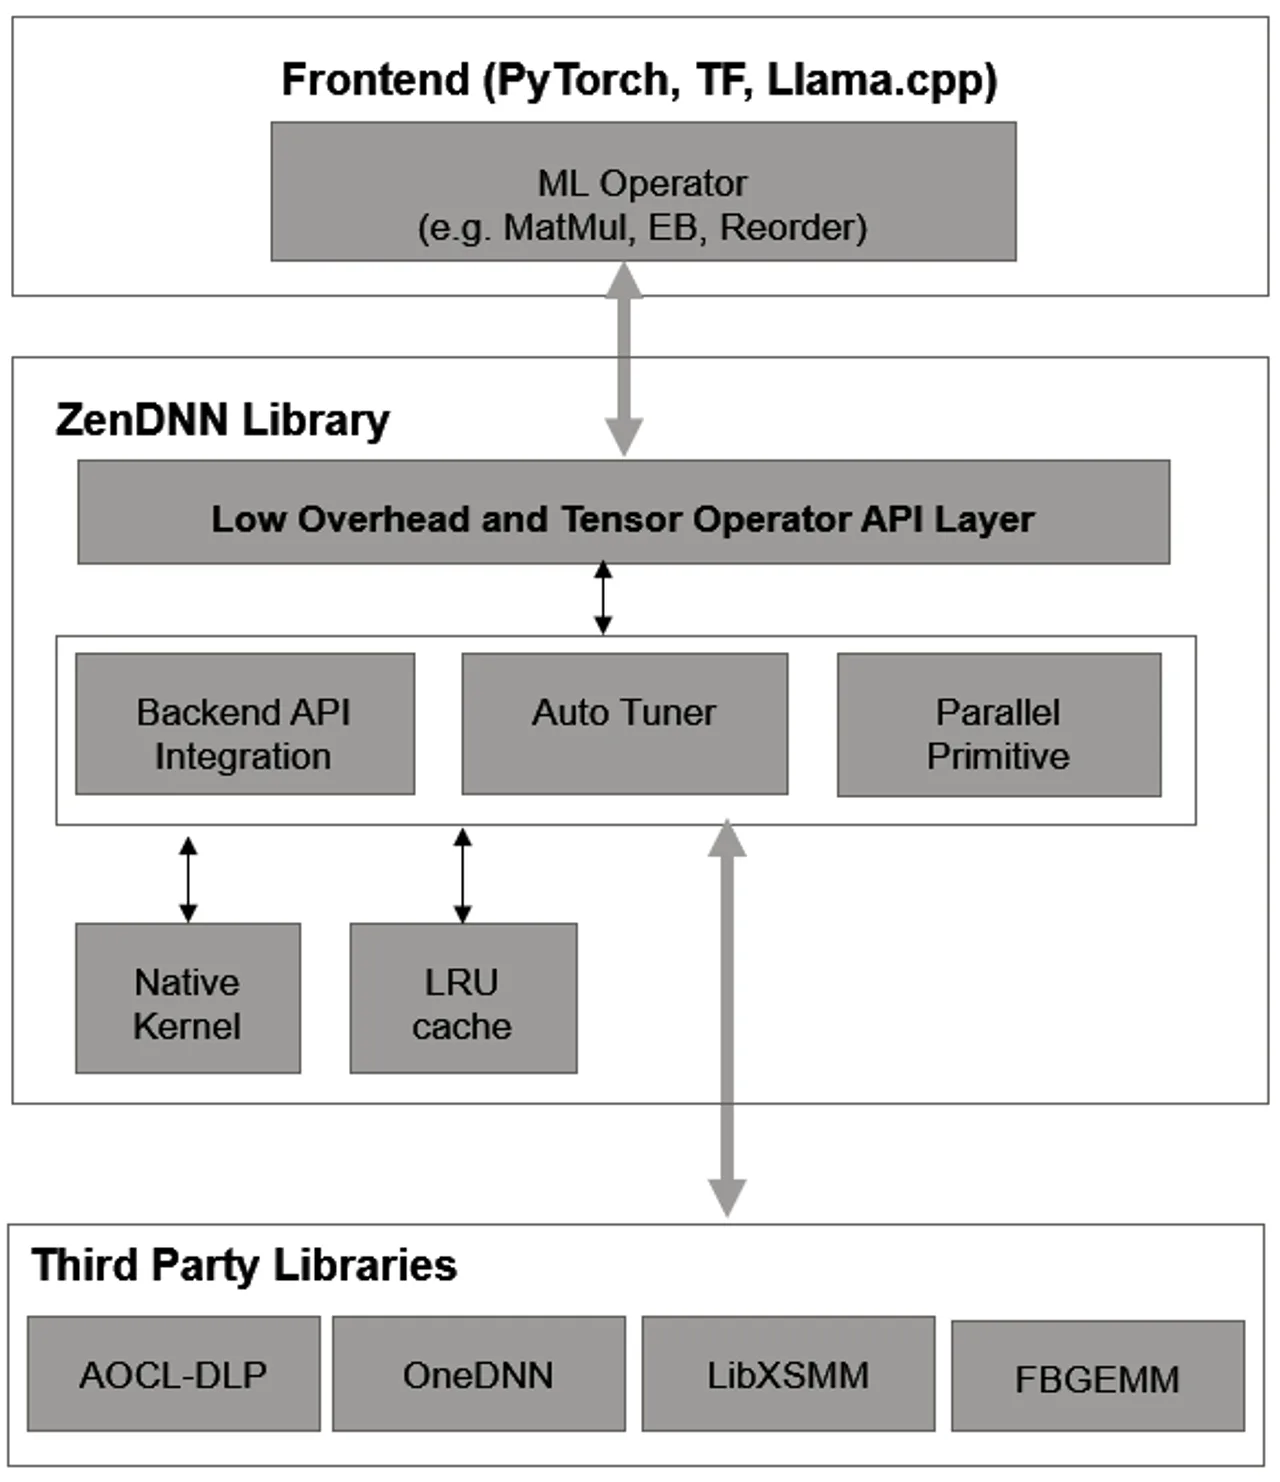
Архитектурная документация объясняет основную идею LowOHA через стоимость частых коротких вызовов. Операция принимает указатели на данные и параметры размещения, минуя создание объектов фабрики операторов и дополнительного контекста на горячем пути. Это важно, когда сами небольшие матричные вычисления занимают мало времени, а подготовка к каждому вызову становится заметной частью работы.
Рядом сохраняется объектный Tensor Operator API. Он нужен интеграциям, которым удобны явные тензоры, контексты и операторы. Это не два взаимоисключающих продукта: оба интерфейса ведут к вычислительной библиотеке, но предоставляют разный уровень представления операции. В документации LowOHA выделен как приоритетный путь для новых интеграций, чувствительных к задержкам и накладным расходам.
Какие данные описывают операцию
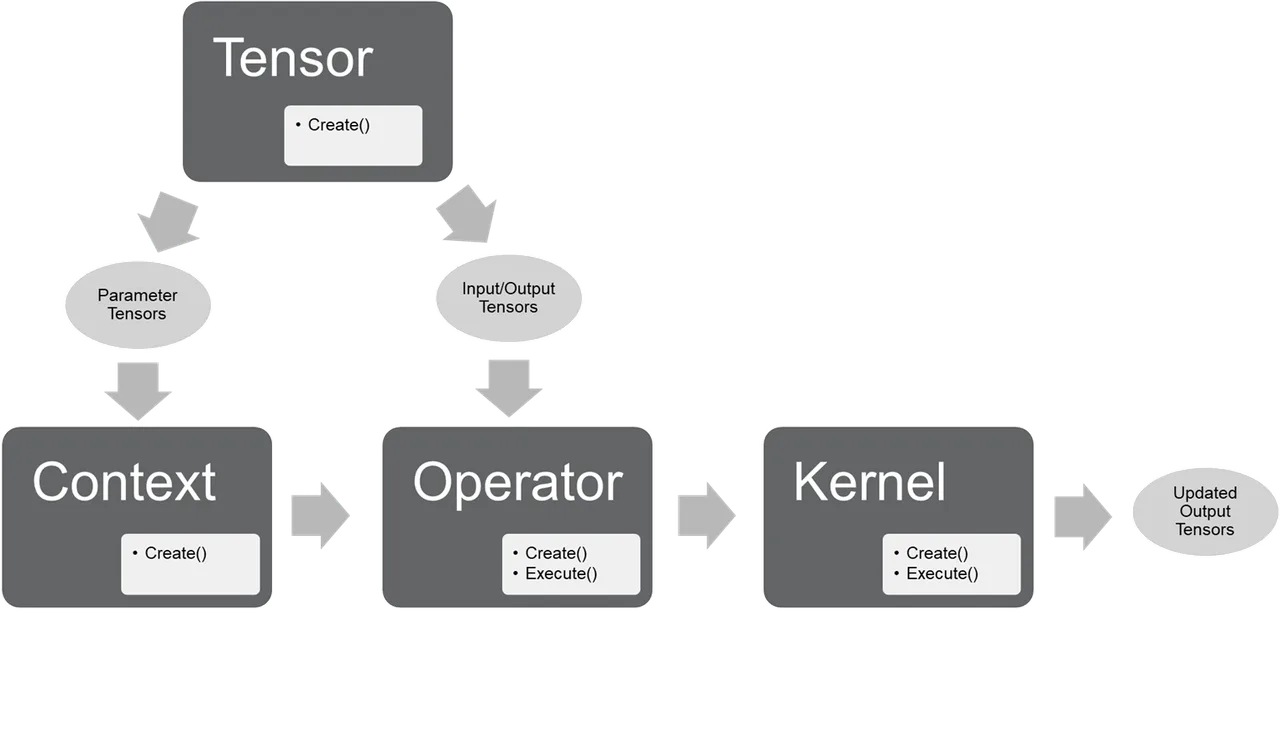
Тензор в документации — не только буфер чисел. Его описание включает размерности, форму, шаги размещения и тип данных. Для квантованных представлений дополнительно используются масштаб и смещение нуля. Эти сведения нужны, чтобы интерпретировать содержимое памяти правильно; одинаковое количество байтов ещё не означает одинаковый вход для вычисления.
Контекст хранит постоянные параметры и настройки выполнения, оператор описывает действие, а ядро выполняет аппаратно-ориентированный код. Схема в статье показывает именно это разделение. Среди поддерживаемых операций документация перечисляет матричное умножение, нормализацию, преобразование расположения данных, embedding bag, свёртку, pooling и softmax. Поэтому поддержка библиотеки определяется не одним названием нейросети, а тем, как её операции представлены и передаются через интеграцию.
Кэширование и выбор вычислительного пути
В 6.1 хранение весов in-place включено по умолчанию; предусмотрены публичные API очистки кэшей и возможность отключить их глобально. Для routed MoE добавлен интерфейс с заранее квантованными INT8-данными. В числе обновлений нормализации названы объединённые layer-norm-add и RMS norm с накоплением FP32. Это изменения конкретных операций, а не обещание одной точности для всех промежуточных вычислений.
Архитектура ZenDNN использует несколько вычислительных библиотек и выбирает путь с учётом размеров задачи. README перечисляет AOCL DLP, а также опциональные OneDNN, LibXSMM и FBGEMM. Внешние интеграции с фреймворками вынесены в отдельные проекты, поэтому номер ZenDNN не является номером готового пакета PyTorch или TensorFlow. Совместимость сборки и соответствующего плагина определяется отдельно от списка новых ядер библиотеки.